O que é debug e como encontrar erros no código mais rápido
Escrever um bug não é o pior tropeço de quem está começando. É passar duas horas trocando linhas no escuro, rodando o programa de novo e torcendo para a mensagem vermelha sumir. Esse método de tentativa e erro até funciona em código de 30 linhas, mas num projeto de verdade ele queima uma tarde inteira e, muitas vezes, “conserta” o sintoma enquanto a causa continua lá.
$ ls ./neste-artigo
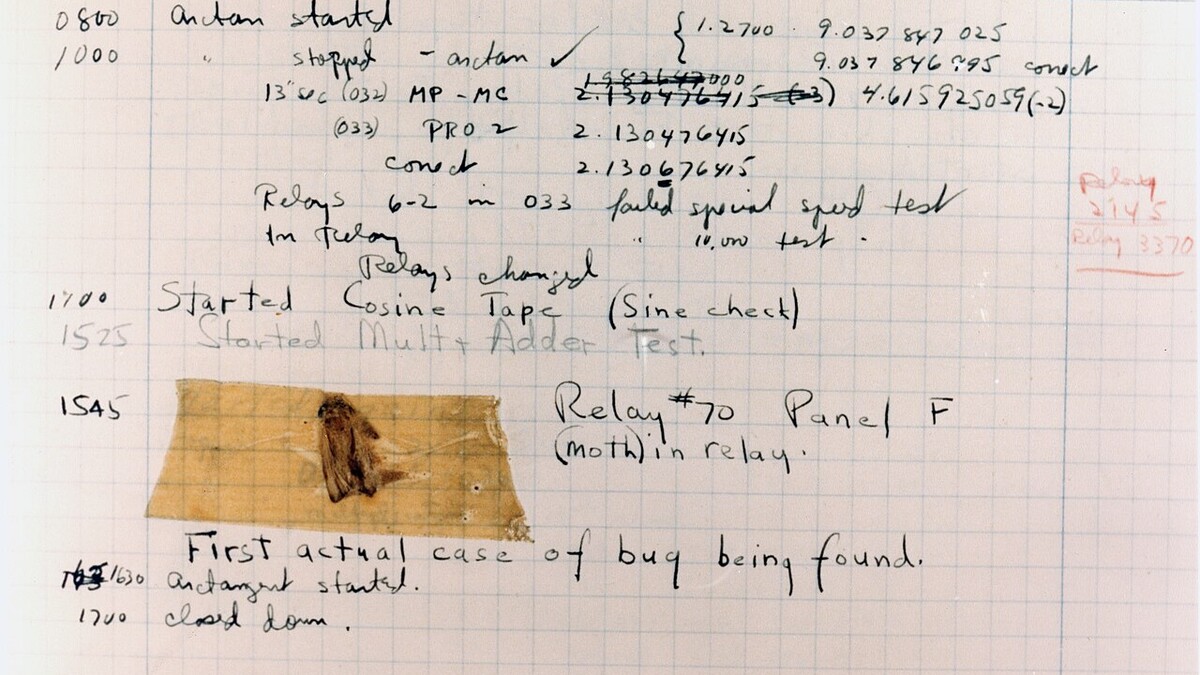
Debug (ou depuração) é o trabalho de encontrar por que o programa faz algo diferente do que você esperava e corrigir a causa. O nome vem de bug, inseto em inglês, e a palavra já circulava entre engenheiros antes da computação. A história mais conhecida é de 1947: a equipe que operava o computador Mark II, em Harvard, achou uma mariposa presa num relé e colou o inseto no caderno de registro com a anotação “primeiro caso real de bug encontrado”.
Em três passos: reproduza o erro de forma confiável, reduza o espaço onde ele pode estar e confirme a causa olhando valores reais (não suposições). Ferramenta boa encurta cada passo, mas a ordem é o que faz você chegar mais rápido.
Depurar começa antes de abrir o depurador
Quase todo dev júnior pula direto para o código. Quem depura rápido gasta os primeiros minutos lendo, e lendo com atenção, a mensagem de erro.
1. Leia o stack trace de baixo para cima (ou de cima para baixo, conforme a linguagem)
O stack trace é a pilha de chamadas que levou ao erro. Em Python, a linha mais importante costuma ser a última, com o tipo da exceção, e logo acima dela o arquivo e a linha onde tudo estourou. Em Java e JavaScript, a primeira linha da pilha é a que interessa. Procure o primeiro arquivo que é seu, não da biblioteca: é quase sempre ali que o problema começou.
Traceback (most recent call last):
  File "pedidos.py", line 42, in calcular_total
    total += item["preco"] * item["qtd"]
KeyError: 'qtd'
Esse trecho já responde muita coisa: algum item chegou sem a chave qtd. A pergunta deixa de ser “por que o total está errado?” e vira “de onde vem um item sem quantidade?”. Bem mais fácil de investigar.
2. Reproduza o erro sempre do mesmo jeito
Um bug que aparece “às vezes” é quase impossível de corrigir com segurança. Anote os dados de entrada, o usuário, o navegador, a hora. Tente chegar a uma receita que dispara o erro toda vez. Se for uma API, salve a requisição exata. Se for uma tela, escreva os cliques em ordem.
Esse passo parece burocrático, mas ele traz um bônus: a receita vira um teste automatizado depois, e o bug não volta escondido daqui a três meses.
Encolher o problema até ele caber na tela
Com o erro reproduzível, o objetivo é reduzir o código suspeito. Programas grandes têm milhares de linhas; o defeito costuma estar em duas ou três.
- Isole a entrada. Corte os dados até sobrar o mínimo que ainda provoca o erro. Uma planilha de 5 mil linhas que quebra a importação geralmente quebra por causa de uma linha só.
- Divida o caminho ao meio. Coloque um ponto de checagem no meio do fluxo. O valor já está errado ali? Então o problema está na primeira metade. Repita. Em poucas rodadas você sai de 500 linhas para 10.
- Desligue partes. Comente uma integração, troque uma chamada externa por um valor fixo. Se o erro some, você achou a vizinhança.
- Compare com uma versão que funcionava. Se ontem estava bom e hoje não está, a diferença entre os dois commits é o seu mapa.
O passo 4 tem uma ferramenta pronta que pouca gente conhece no começo da carreira: o git bisect, na documentação oficial do Git. Você informa um commit bom e um ruim, e o Git faz a busca binária por você, pedindo que marque cada versão intermediária como boa ou ruim. Num histórico de 200 commits, ele chega ao culpado em cerca de 8 passos.
Print, log ou breakpoint: o que usar em cada momento
Todo mundo começa com print() ou console.log(), e não há vergonha nisso. O problema é quando o print vira a única ferramenta. Cada técnica tem seu lugar:
| Técnica | Quando brilha | Onde atrapalha |
|---|---|---|
| print / console.log | Checagem rápida de um valor, scripts curtos | Laços grandes, objetos aninhados, esquecer prints no commit |
| Log com nível (info, warning, error) | Produção, erros que só acontecem no servidor | Exige configurar formato e destino |
| Breakpoint no depurador | Entender o estado completo num ponto exato | Código assíncrono com tempo sensível, ambientes remotos |
| Teste automatizado | Fixar o comportamento esperado e evitar que o bug volte | Investigação inicial, quando você ainda não sabe o que esperar |
3. Pare o programa no ponto suspeito com um breakpoint
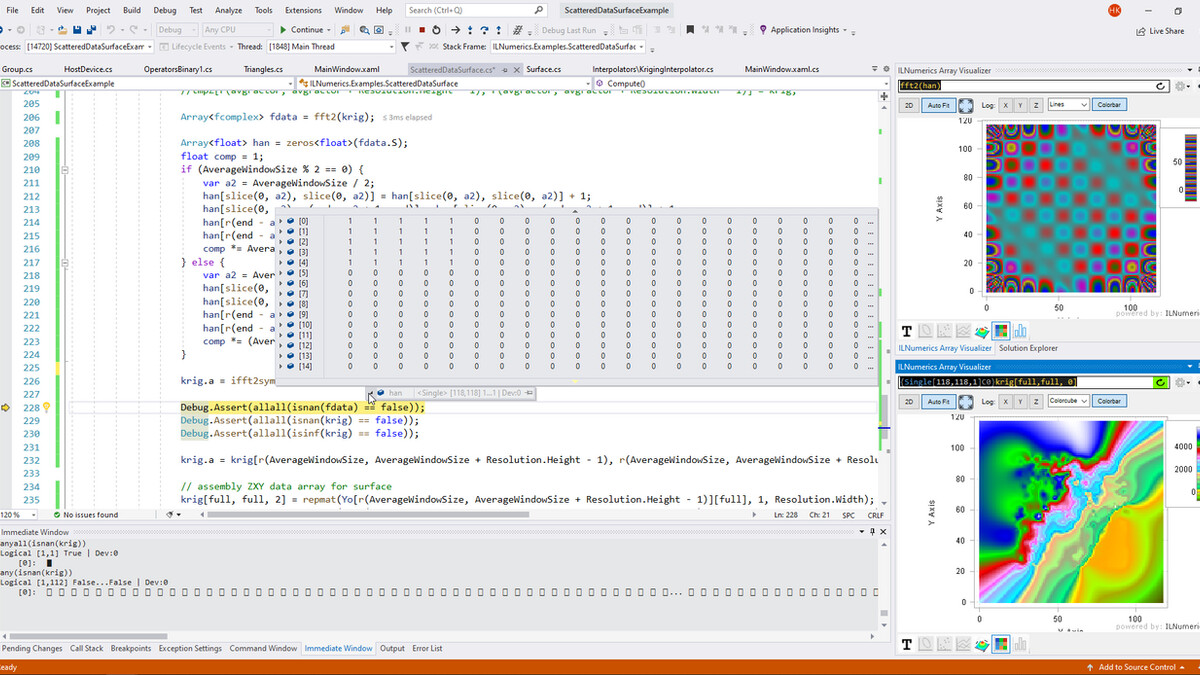
Um breakpoint pausa a execução numa linha e deixa você ver todas as variáveis daquele momento, andar linha a linha (step over), entrar numa função (step into) e sair dela (step out). Nos editores como o VS Code, basta clicar ao lado do número da linha e rodar em modo de depuração.
No navegador, o painel Sources do Chrome faz o mesmo com JavaScript, e o guia como depurar JavaScript no Chrome DevTools mostra o fluxo completo com um exemplo prático. Em Python, sem editor nenhum, uma linha resolve:
def calcular_total(itens):
    breakpoint()   # pausa aqui e abre o pdb no terminal
    total = 0
    for item in itens:
        total += item["preco"] * item["qtd"]
    return total
No prompt do pdb, p itens mostra o valor, n avança uma linha, c continua até o próximo ponto de parada. A referência completa está na documentação do módulo pdb.
4. Use breakpoints condicionais em laços longos
Se o erro aparece no item 3.482 de uma lista, parar em todas as voltas é tortura. Clique com o botão direito no breakpoint e defina uma condição, como item["qtd"] is None. O depurador só para quando a condição for verdadeira. Esse recurso existe no VS Code, no PyCharm, no IntelliJ e no DevTools, e quase ninguém usa nos primeiros anos.
Formular uma hipótese e tentar derrubá-la
Com o problema encolhido e as variáveis à vista, chega a parte mais intelectual do debug. Escreva (sim, escreva) uma frase do tipo “o total sai errado porque a API de estoque devolve itens sem qtd quando o produto está esgotado”. Depois procure a evidência que derrubaria essa hipótese.
Isso evita o vício mais comum: achar uma explicação plausível, aplicar uma correção, ver o erro sumir naquele caso e seguir em frente. Se a hipótese não explica todos os sintomas, ela está incompleta.
Uma técnica antiga e eficaz é o rubber duck debugging: explicar o código em voz alta, linha por linha, para um patinho de borracha (ou um colega paciente). No meio da explicação, você ouve a si mesmo dizer “e aqui ele sempre recebe uma lista” e percebe que não, nem sempre.
- O erro acontece com todos os usuários ou só com alguns?
- Começou depois de qual mudança, deploy ou atualização de biblioteca?
- Acontece só em produção? O que é diferente lá (dados, variáveis de ambiente, fuso horário)?
- O valor errado nasce no seu código ou chega pronto de fora?
Corrigir a causa e travar a porta com um teste
Encontrou? Antes de comemorar, corrija a causa, não o sintoma. No exemplo do KeyError, um item.get("qtd", 0) faz o erro sumir, mas pode gerar um pedido com total zero sem ninguém perceber. Talvez o certo seja rejeitar o item, avisar o usuário ou corrigir a integração que manda dados incompletos.
Depois, transforme a receita de reprodução do passo 2 num teste. Ele falha antes da correção e passa depois dela. Esse teste é o que impede o mesmo bug de voltar quando outra pessoa mexer no arquivo daqui a seis meses.
Por fim, apague os prints esquecidos e os breakpoints no código. Um breakpoint() que vai para produção trava o servidor esperando alguém digitar no terminal, e esse é um bug que você mesmo criou depurando outro.
Debug em produção pede outras armas
No servidor, você não pode pausar o programa enquanto clientes esperam. Ali o trabalho depende do que foi preparado antes:
- Logs estruturados, com identificador da requisição, para seguir um pedido do começo ao fim.
- Monitoramento de erros, que agrupa exceções iguais e mostra quantas vezes cada uma aconteceu.
- Ambiente de homologação com dados parecidos com os reais, para reproduzir o problema longe dos clientes.
Se você está no começo e ainda monta seus primeiros projetos, o texto sobre por onde começar a jornada na codificação ajuda a organizar os estudos, e depurar bem merece entrar nessa lista desde cedo, junto com a sintaxe da linguagem.
Seu próximo bug, passo a passo
Na próxima mensagem vermelha, resista à vontade de mexer no código no primeiro minuto. Leia a pilha, ache o seu arquivo, reproduza o erro, coloque um breakpoint antes da linha que estourou e olhe os valores reais. Faça isso cinco vezes e o hábito fica. Para os outros termos que aparecem nesse caminho, como stack trace, exceção e teste unitário, o glossário de programação tem um verbete curto para cada.